Claude Sonnet 5: mạnh gần bằng Opus, giá chỉ 2 đô
Ảnh: Anthropic
Ngày 30/6, Anthropic phát hành Claude Sonnet 5. Nghe tên thì chỉ là bản nâng cấp tầng giữa, nhưng con số mới là chuyện đáng nói: trên các bài đo agentic như BrowseComp hay OSWorld-Verified, Sonnet 5 nhiều lúc bám sát Opus 4.8 — mô hình đầu bảng của chính Anthropic — trong khi giá khuyến mãi chỉ 2 đô cho mỗi triệu token đầu vào, 10 đô mỗi triệu token đầu ra (áp dụng đến hết 31/8, sau đó về mức chuẩn 3/15 đô). Người dùng Free và Pro trên Claude.ai, Claude Code lẫn API được chuyển sang Sonnet 5 làm mặc định ngay từ hôm ra mắt.
Khi "hàng phổ thông" làm được việc của hàng cao cấp
Trước nay giới làm sản phẩm AI vẫn chia việc khá rạch ròi: việc khó đưa lên flagship, việc số lượng lớn giao cho mô hình rẻ. Sonnet 5 làm ranh giới đó lung lay. Theo Anthropic, điểm khác biệt lớn nhất so với Sonnet 4.6 là khả năng theo đuổi tác vụ dài nhiều bước đến cùng — những chỗ các bản Sonnet cũ hay bỏ cuộc giữa chừng — cộng thêm suy luận tốt hơn, dùng công cụ mượt hơn và ít bịa hơn.
Có một chi tiết thú vị: năng lực về an ninh mạng của Sonnet 5 bị cố tình giới hạn so với tầng Opus và Fable. Sau vụ Fable 5 bị áp lệnh kiểm soát xuất khẩu hồi tháng 6, có thể thấy Anthropic đang chủ động phân tầng sản phẩm theo mức độ nhạy cảm, chứ không đơn thuần theo sức mạnh.
Cuộc chiến giá đã nổ ra
Mức 2 đô xuất hiện đúng lúc thị trường đang khó chịu với giá mô hình frontier — CEO Palantir vừa công khai chê ngành này "vắt kiệt" doanh nghiệp, còn Uber thì cắt giảm ngân sách AI. Giờ đây, một mô hình gần bằng Opus mà giá bằng Sonnet sẽ khiến mọi hóa đơn flagship phải có lời giải thích: workload này có thật sự cần mô hình đắt nhất không?
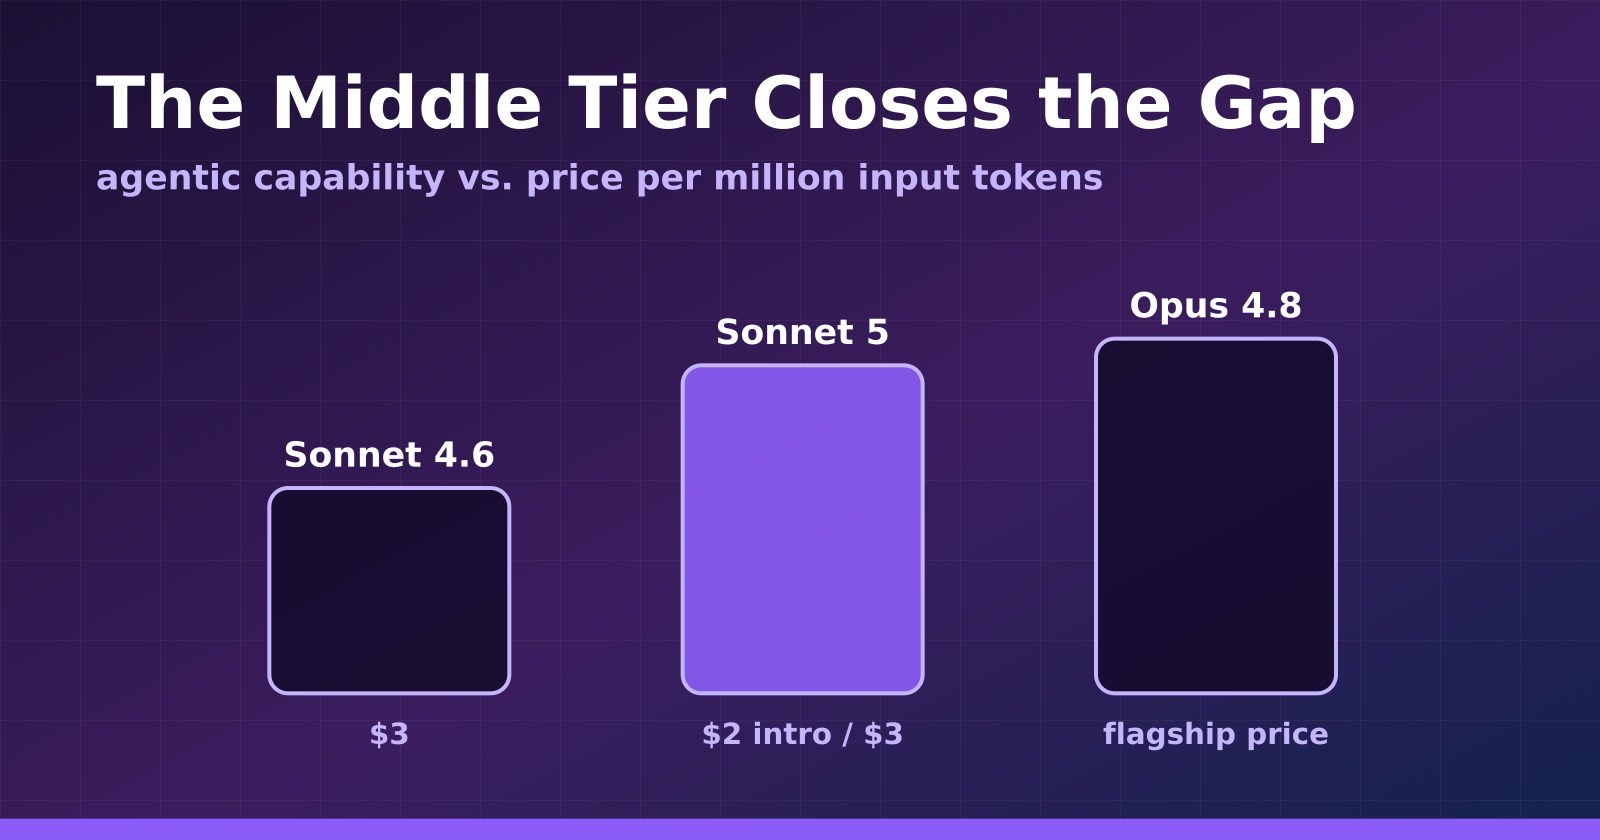
Chú thích: Sonnet 5 kéo hiệu năng tầng giữa lên sát flagship, trong khi giá gần như đứng yên.
Với các đội đang nhúng Claude API vào sản phẩm, còn một việc cần làm ngay: traffic Free và Pro giờ chạy Sonnet 5. Output trung bình sẽ tốt lên, nhưng là output khác — các bộ kiểm tra chất lượng nên chạy lại từ đầu.
Lời khuyên kỹ thuật: đo xong hãy đổi
Đừng đổi mô hình chỉ vì đọc thông cáo báo chí. Cách làm chắc tay: lấy 50–100 tác vụ thật từ log (nhớ kèm những ca xấu nhất), chạy song song trên Sonnet 5, mô hình đang dùng và flagship, rồi chấm cùng một thang điểm. Quyết định theo từng loại việc — câu hỏi hay không phải "dùng Sonnet 5 hay Opus cho tất cả" mà là "20% việc nào vẫn đáng tiền flagship".
Vài quy tắc nhỏ: ghim rõ phiên bản claude-sonnet-5 trong file cấu hình, bật mặc định mới sau feature flag, giữ route cũ chạy song song thêm một chu kỳ thanh toán. Và nhớ tính chi phí theo giá chuẩn 3/15 đô — giá 2 đô chỉ sống đến hết tháng 8.
Nguồn: Anthropic, TechCrunch, Fello AI.
Còn bạn thì sao? Nếu mô hình tầng giữa gánh được 80% công việc, bạn còn lý do gì để trả giá flagship cho phần còn lại?
Sẵn sàng sắp xếp tri thức với AI?
BrainMap tự động phân loại ghi chú, khám phá kết nối và xây dựng đồ thị tri thức cá nhân. Miễn phí — không cần thẻ tín dụng.
Dùng thử miễn phíBài viết liên quan
Báo cáo đe dọa của Anthropic và câu hỏi có nên chậm lại
Anthropic cho biết họ đã ngăn chặn việc lạm dụng Claude cho nghiên cứu vũ khí sinh học, gián điệp mạng có liên hệ với Nga nhằm vào Ukraine và trích xuất năng lực của Claude. Một vụ tấn công bị bỏ sót đang làm dấy lên câu hỏi về tốc độ phát triển mô hình.
Siri AI trên iOS 27: Apple đưa ngữ cảnh cá nhân lên trợ lý ngay trên thiết bị
Siri AI beta trên iOS 27 hiểu ngữ cảnh từ email, tin nhắn, lịch, ảnh và ghi chú, với nhận biết màn hình và tác vụ liên ứng dụng.
Claude Fable 5.1: Vòng lặp agent rẻ hơn, an toàn phân tầng
Anthropic phát hành Fable 5.1 và Mythos 5.1 với cùng một model nhưng hai mức bảo vệ, trong khi giá đọc bộ nhớ đệm giảm mạnh làm thay đổi bài toán chi phí của agent chạy dài.